
商品详情
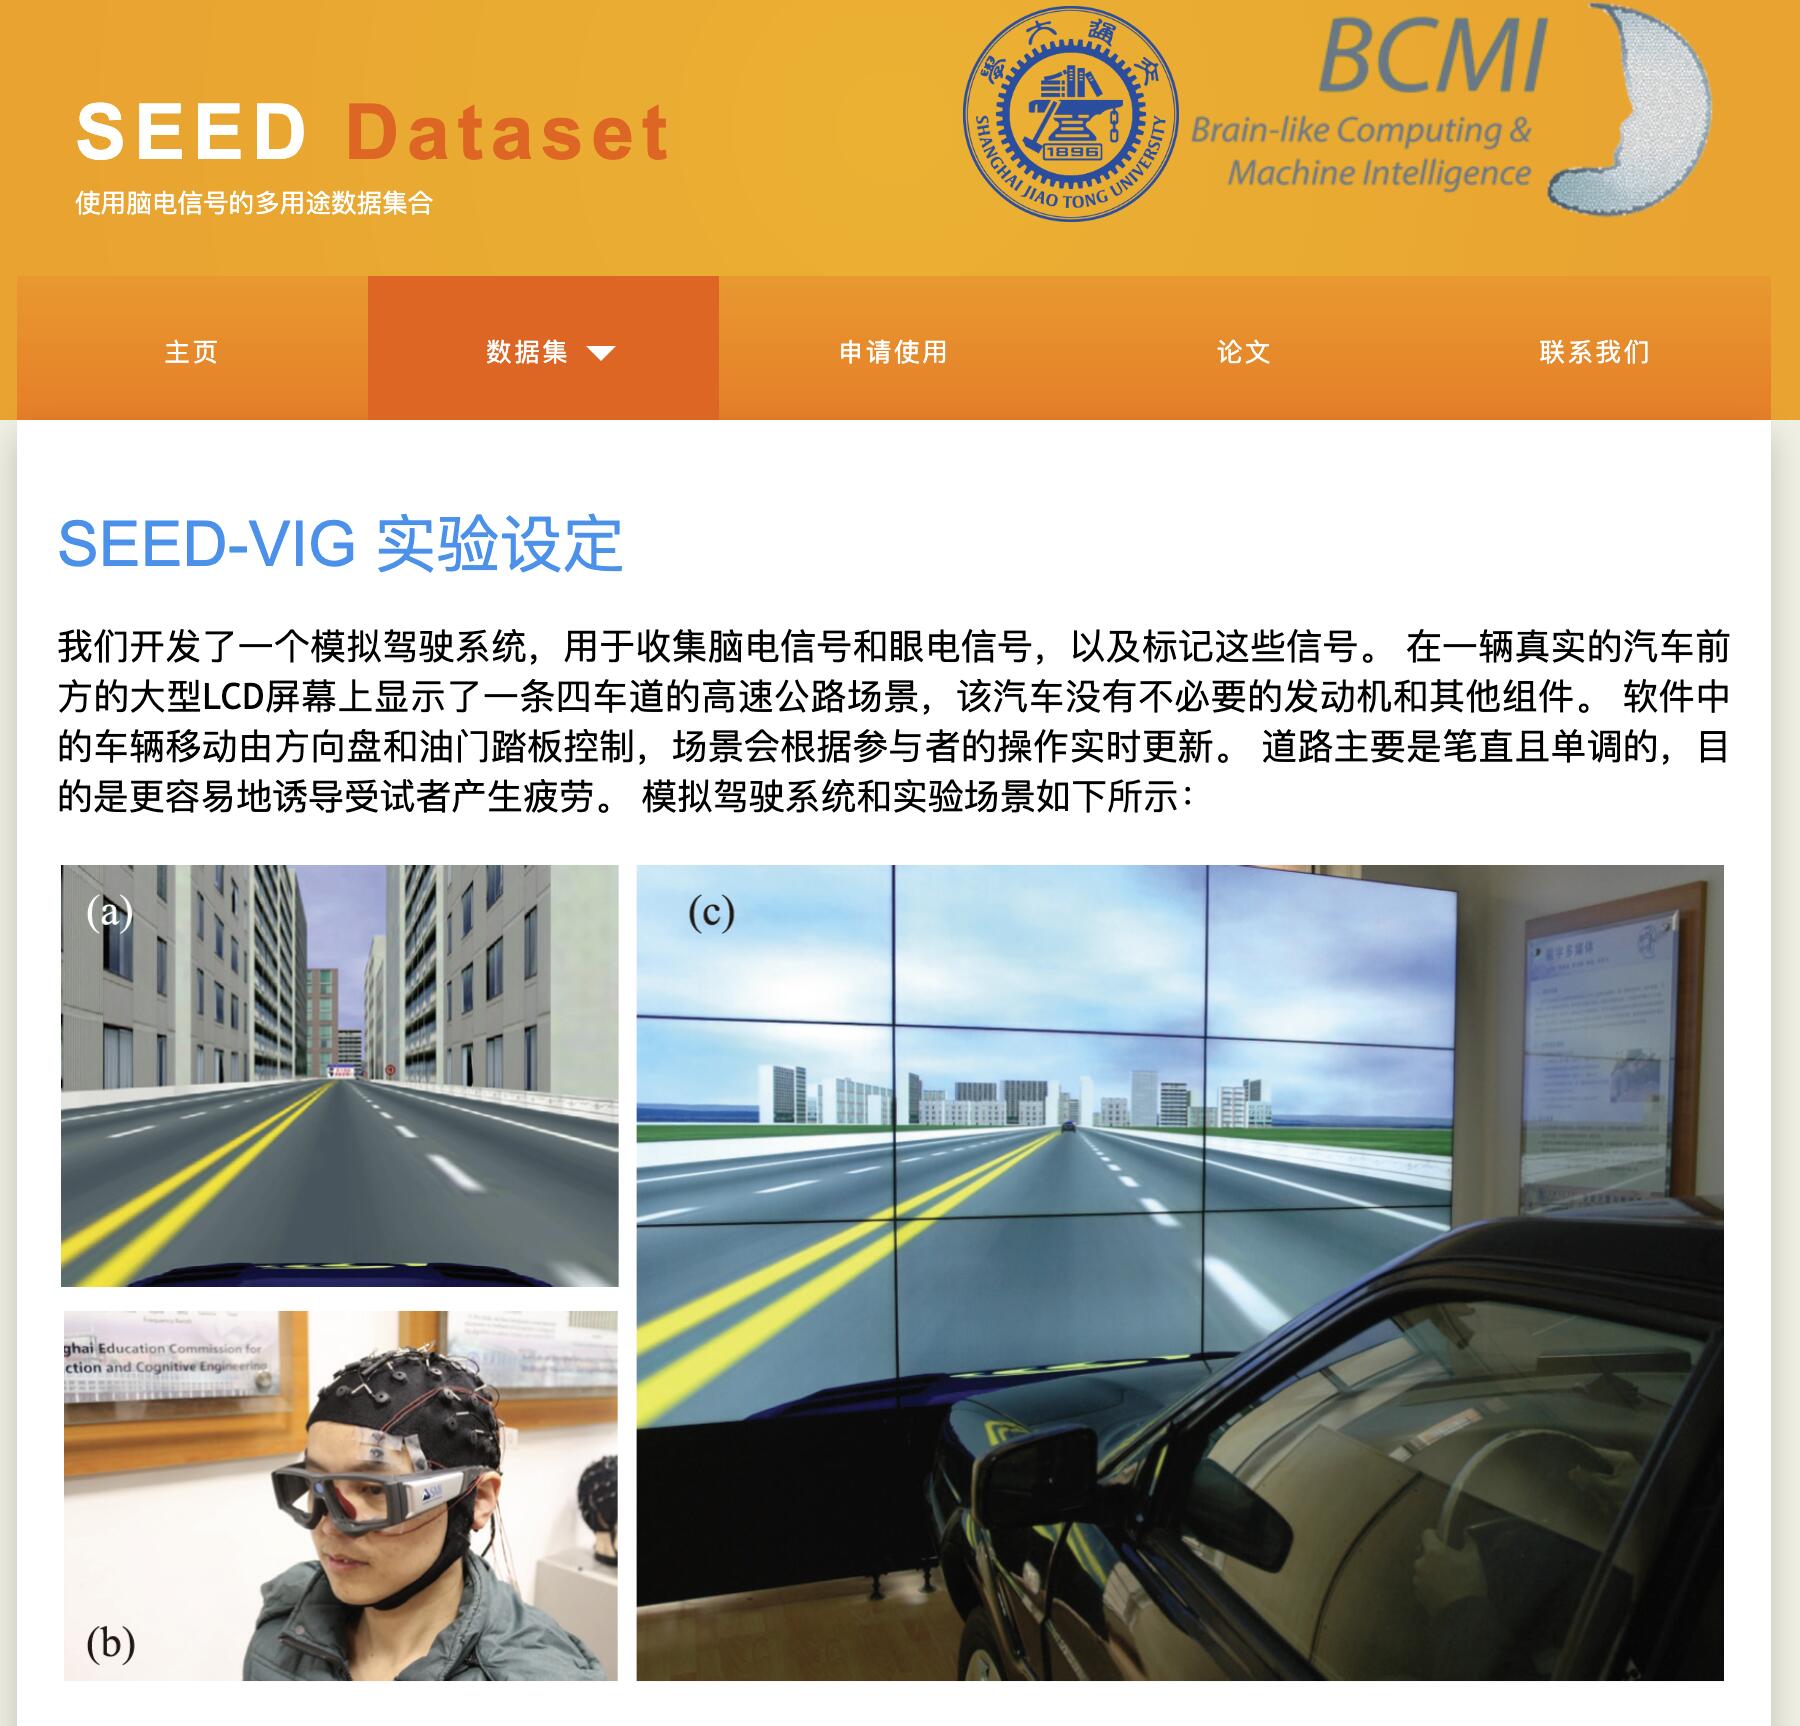
送SEED-VIG数据集
我们提出 BFT(Backpropagation-Free Transformations):一种面向脑电(EEG)脑机接口在线部署的测试时自适应框架。它的核心思想是——不去更新模型的任何一个参数,而是对每一条测试试次施加一组结构化的、保持标签语义的变换,把由此产生的多个预测聚合成一个更可靠的输出。
之所以可行,是因为一个已经与目标被试对齐的模型,在受到轻微扰动时其预测应当保持稳定;预测在不同变换下的离散程度因此可以作为"不确定性"的代理量。我们把这种不确定性显式地学出来:训练一个可靠性排序模块,让它判断哪些变换分支更可信,并在推理时按可信度加权。
跨被试 / 跨场次的分布漂移会让离线训练好的解码器性能显著下降。经典的迁移学习(域自适应、测试时自适应)大多通过反向传播更新参数来缓解这一点,但在真实的 BCI 部署中,这条路线会同时撞上四面墙:
| 约束 | 具体表现 |
|---|---|
| 算力成本 | 低功耗边缘设备(可穿戴、嵌入式)没有 GPU;模型经 INT8 量化后难以再做反向传播微调。 |
| 隐私风险 | 更新参数必须接触模型内部权重,与黑盒 / 隐私保护的部署诉求冲突;医疗场景尤其敏感。 |
| 测试流噪声 | EEG 极易受疲劳、体动、出汗、电极接触不良影响。基于熵最小化一类的目标函数在噪声样本上会产生负迁移,还会让超参选择变得极不稳定。 |
| 任务限制 | 绝大多数方法依赖 softmax 概率与熵,天然只适用于分类;回归任务(如连续警觉度/疲劳度估计)几乎无人处理。 |
我们的目标因此被明确定义为一个前向-only、隐私安全、抗噪、且对分类与回归通用的测试时自适应框架。
设流式测试集为 D_test = {x_t},其中 x_t 为当前到达的测试试次。部署在设备上的模型由两部分组成:特征提取器 g(·) 与任务头 h(·)(分类器或回归器),二者在源域训练集 D_train = {(x_i, y_i)} 上训练完成后被冻结。
测试时自适应在每个时刻 t 只能使用 {x_t, ŷ_t, g, h}:当前输入、它的初始预测、以及冻结的两个模块。不允许访问训练数据、真实标签、梯度,也不允许依赖批次内其它样本。
整个流程分为"源域准备"与"测试时推理"两段:源域阶段训练任务模型 g∘h 并额外训练一个小型可靠性排序模块 r;测试阶段对每个 x_t 并行生成 K 个变换分支,由 r 给出可靠性权重,再加权聚合。

g、h,同时训练可靠性排序模块 r;测试阶段对每个试次 x_t 生成 K 个保持标签语义的变换分支,经冻结的 g 得到特征 z_t^(k),由 r 给出可靠性、由 h 给出预测,最后按可靠性加权聚合。全过程只有前向传播。我们设计了两族互补的变换。它们都是保持标签语义的:变换后的样本仍然对应同一个标签 / 同一个连续真值。
直接把 EEG 领域常用的增强手段搬到测试时:
此外保留一路恒等变换(Identity)作为参考分支。变换后的特征为
受 Monte-Carlo Dropout 启发,但我们不做逐试次的随机重采样,而是构造一组固定的特征掩码,每个掩码定义一个可复现的子网络。固定性是必须的:只有分支 k 在训练和部署时是"同一个分支",第 3.4 节中的分支级排序才有意义。掩码定义为
其中 d 是特征维度,1/K 对应训练时的 dropout 率 p。相应地
系数 1/(1−p) 用于补偿被置零后激活幅度的损失,使特征向量的期望与训练时保持一致。
BFT-A 作用在输入数据上,BFT-D 作用在特征上。二者都需要对同一条测试样本做多次前向,但由于可以组成批次做矩阵运算,实际开销很小。回归任务上我们使用 K = 12(BFT-A)与 K = 10(BFT-D)。
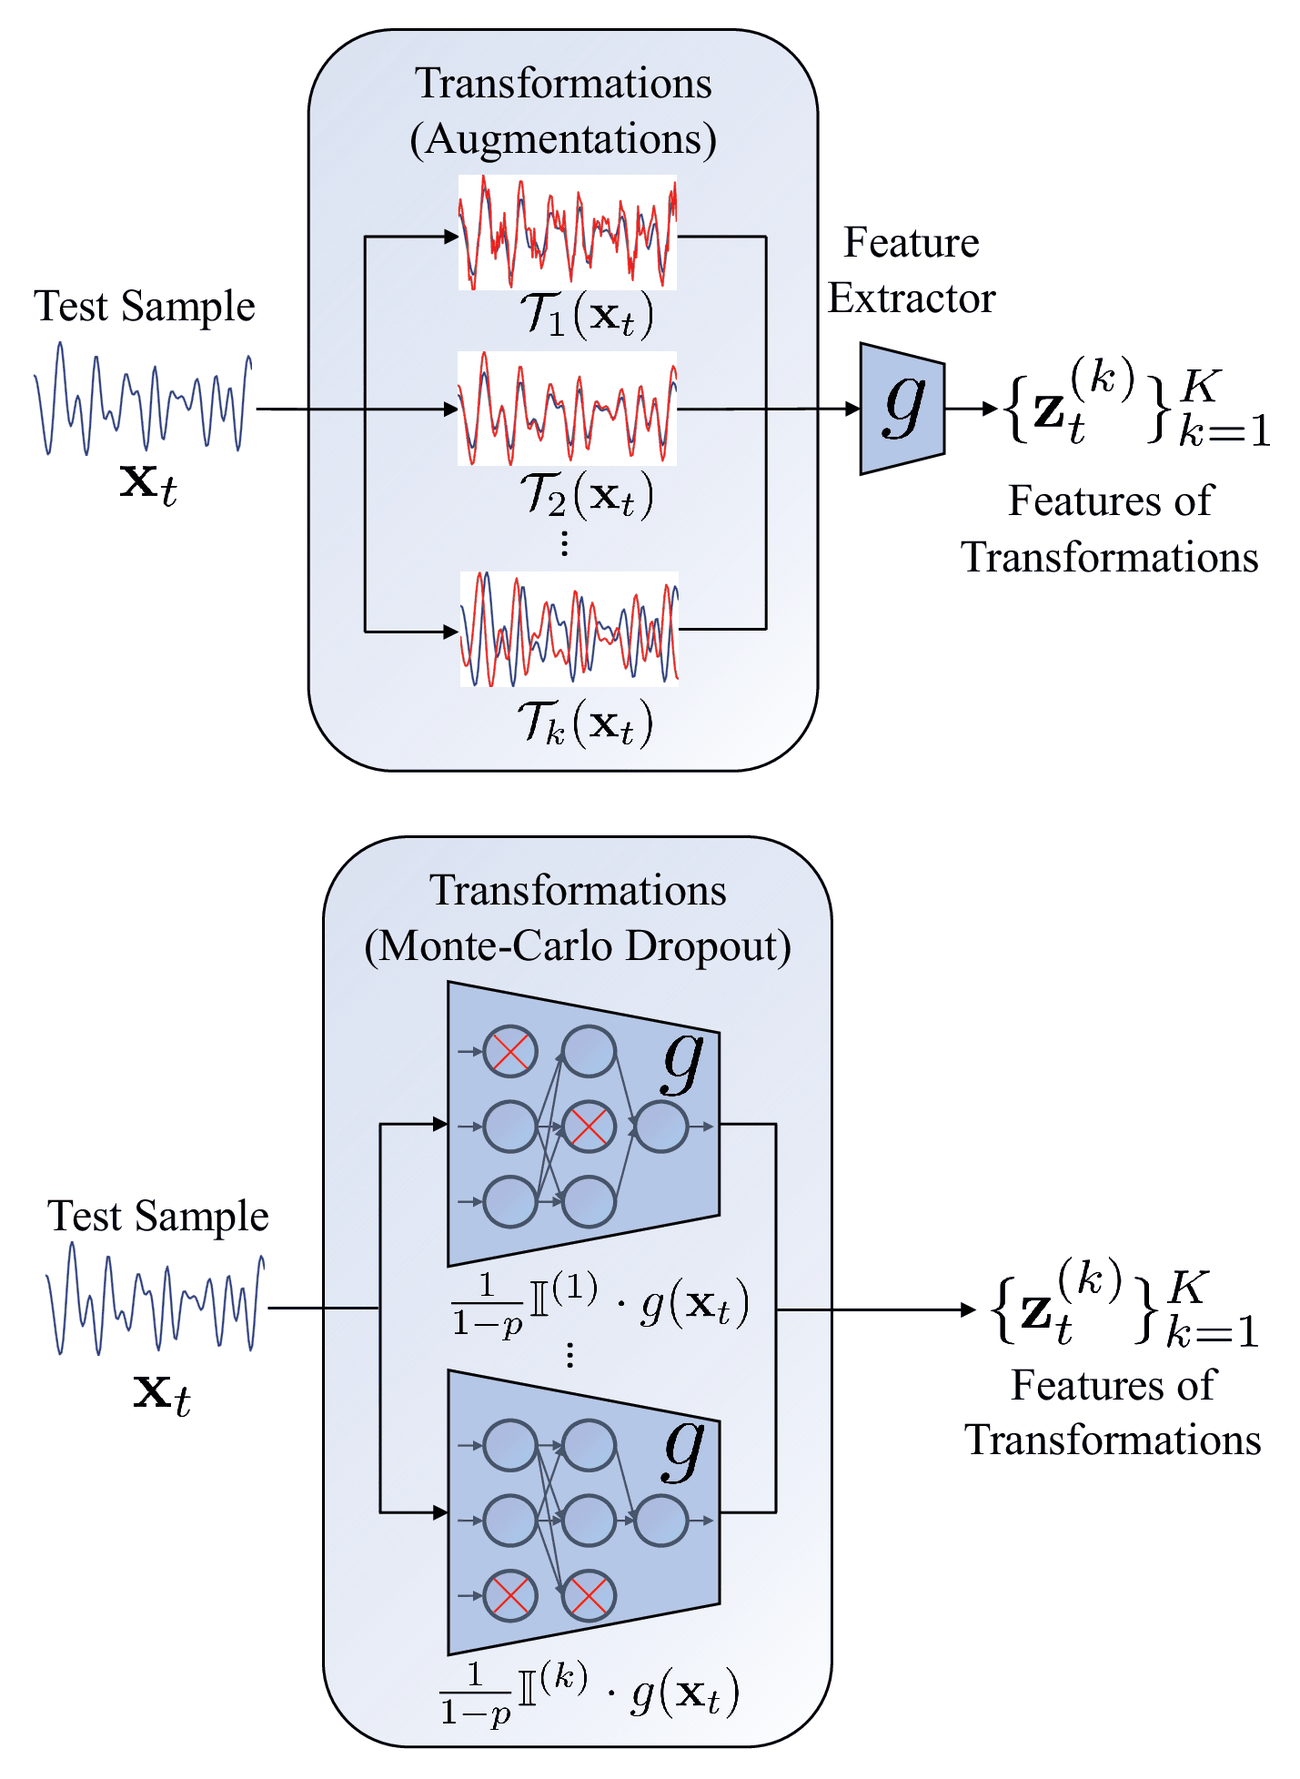
x_t 施加 K 个知识驱动的增强,再送入特征提取器 g;下:BFT-D,用一组固定掩码在特征层构造子网络库,得到 K 组特征表示。不同的变换其预测质量并不相同,简单地等权平均会浪费信息。我们希望为每个分支学出一个可靠性分数,再用它加权。一个朴素的做法是直接用任务损失 h 的大小当作可靠性,但这有四个问题:
r 只是在蒸馏 h 已有的知识,没有引入新信息;h(g(·)) 已被优化得很好,各分支的损失值量级非常接近,梯度信号微弱;因此我们把它改造成一个排序问题:让 r(·) 输出的可靠性分数尽可能呈现出与"真实名次"一致的次序。由于名次是离散量、不可导,我们引入一个辅助的映射模块 m(·),先把名次监督信号投影到连续空间,从而避免不可导的投影操作。
m 是一个轻量网络,用合成数据预训练即可。合成样本 x̃ ∈ R^K,每个分量独立地取自 [0, 1];对应的真值名次向量 π̃ ∈ R^K,分量取值于 {1, 2, …, K}。优化目标为 L1 损失:
注意 m 的输入输出空间都是连续的,这使它既能逼近"类名次"的取值,又保持可导。
r 以变换后的特征 {z_i^(k)} 为输入,输出 K 个可靠性分数;先经 Softmax 归一化为权重:
真值名次向量 π_i 由任务模块 h 在各分支上的表现确定。训练目标同样是在"类整数空间"里的 L1 回归:
通过把"名次数值"与"直接由任务损失监督"解耦,r 能把原本非常接近的可靠性分数拉开间距,从而更准确地刻画各变换的优劣。
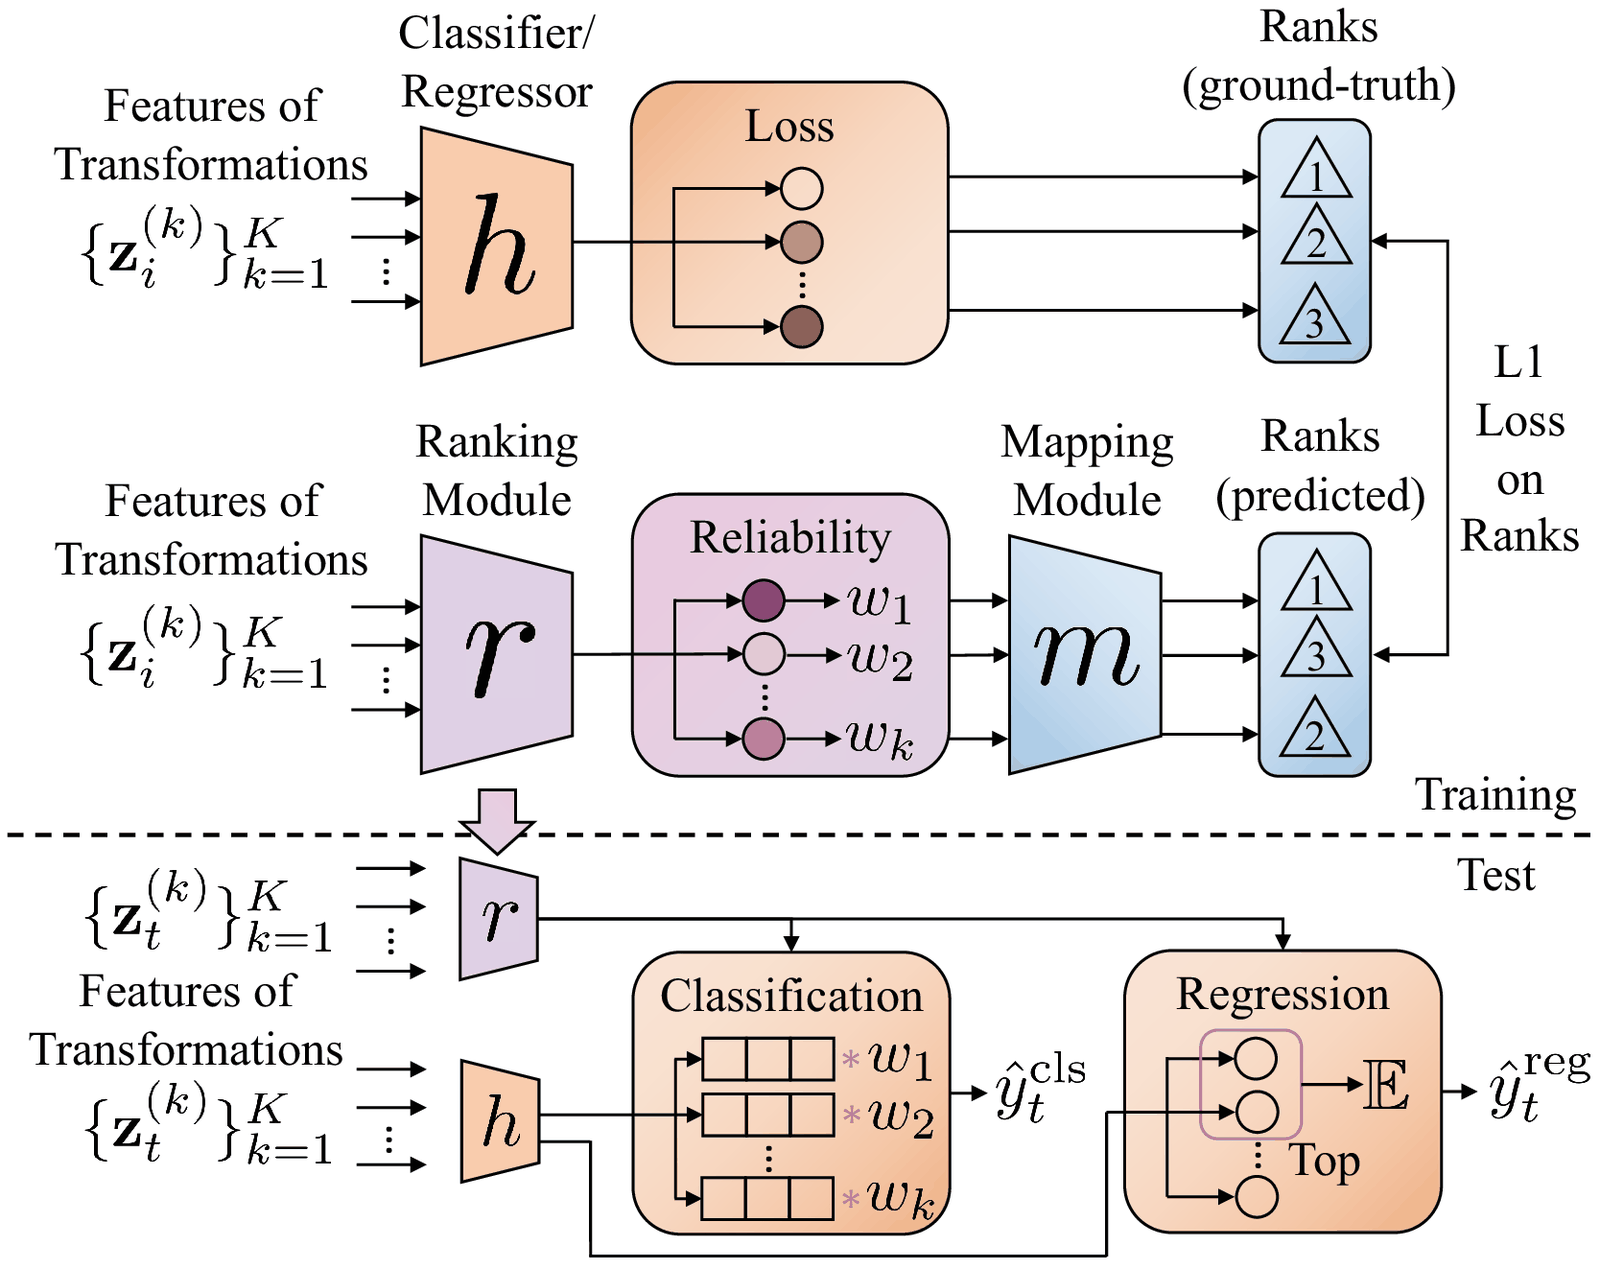
π,映射模块 m 把排序模块 r 输出的分数投影到名次空间,以 L1 损失监督。下半部分是测试阶段:r 给出可靠性权重,分类任务做加权凸组合,回归任务取可靠性最高的前一半分支求均值。分类的聚合可以视作"给更可靠的分支更高权重"的集成。我们把分类头 h 的 logit 先用温度 τ 做锐化(τ 通常取小于 1 的 2 的幂),再经 Softmax 变成概率,最后以可靠性分数为权重做凸组合:
回归输出是连续标量而非单纯形上的概率分布,加权凸组合并不适用。我们改为按可靠性排序取前一半分支求均值:设 k′j 是可靠性 r(z_t^(k)) 第 j 大的分支下标,则
之所以用"基于次序"的筛选而不是"基于分数"的加权,是因为式 (6) 的优化目标只约束了各分支可靠性的相对次序,并没有标定出与误差成反比的数值幅度;因此与所学量相匹配的聚合方式正是次序选择。取前一半(⌈K/2⌉)意味着保留更可靠的多数分支。
# 源域阶段(离线,只做一次)
1  在 D_train 上训练任务模型 g 与 h,随后冻结
2  用合成样本 {x̃, π̃} 以 L_mapping 预训练映射模块 m
3  用 D_train 以 L_ranking 训练排序模块 r
   # 真值名次 π_i 由任务损失在各变换分支上的排序给出

# 测试阶段(在线,对每条测试样本 x_t)
4  生成 K 个变换分支:BFT-A 作用于输入 / BFT-D 作用于特征
5  一次性前向:z_t^(k) = g(T_k(x_t)),k = 1…K
6  由 r 得到可靠性分数,Softmax 归一化为权重 w_t
7  分类:按式 (7) 加权凸组合;回归:按式 (8) 取 top-half 均值
8  输出 ŷ_t —— 全程无梯度、无参数更新、无批次依赖
我们给出了一个基于方差的分析:把多个保持标签语义的变换的预测聚合起来,可以降低预测方差;当各分支质量不齐时,再引入可靠性加权能进一步降低方差。理论分析同时指出了成立条件——只有在变换确实保持标签语义、且分支间误差不完全相关时,聚合才严格有益。这解释了为什么"变换覆盖度"是方法的边界:当部署时的分布漂移超出变换库所能覆盖的范围时,收益会自然衰减。
SEED-VIG 官方发布的 Raw_Data 几乎没有做带通滤波。如果直接把它送进网络,跨被试回归的相关系数会从 0.63 掉到 0.42——比本文所有方法增益加起来的影响还大。因此我们把滤波写进标准流程。
对官方原始数据做 Welch 功率谱估计(200 Hz 采样,60 s 数据,17 通道平均),以 0.5–90 Hz 的平均功率为基准:
| 频段 | 相对功率 | 说明 |
|---|---|---|
| 0.5 – 1 Hz | ≈ 44 × | 极低频漂移占绝对主导,远未滤除 |
| 1 – 4 Hz | ≈ 11 × | 漂移能量仍然很高 |
| 4 – 8 Hz | ≈ 1.3 × | 接近平均 |
| 8 – 14 Hz | ≈ 0.58 × | α 节律 |
| 14 – 31 Hz | ≈ 0.42 × | β 节律 |
| 31 – 50 Hz | ≈ 0.36 × | γ 节律 |
| 100 Hz(Nyquist) | ≈ 94 × 邻域 | 重采样残留的伪峰 |
scipy.signal.filtfilt,前后各滤波一次)iirnotch(50 Hz, Q=30);1–50 Hz 带通已覆盖作为对照,我们也实现了另一套常见的第三方预处理配方(0.1–75 Hz 带通 + 50 Hz 陷波 + 逐通道 z-score),两者在本任务上结果同量级,说明具体选哪个通带并不敏感,敏感的是"到底滤没滤"。
下表是同一套代码、同一 LOSO 划分下,逐被试 Pearson 相关系数的对比:
| 被试 | 1 | 7 | 8 | 11 | 16 | 17 | 21 | 均值 |
|---|---|---|---|---|---|---|---|---|
| 原始数据(未滤波) | 0.839 | 0.052 | 0.231 | 0.213 | 0.293 | −0.330 | 0.232 | 0.4715 |
| 1–50 Hz 带通 | 0.889 | 0.376 | 0.301 | 0.373 | 0.491 | 0.232 | 0.232 | 0.6208 |
可以看到滤波并不是"均匀地小幅提升",而是专门救回那些原本崩掉的被试(如被试 7 从 0.052 → 0.376,被试 17 从 −0.330 → +0.232)。由于汇总指标会被最差的几个被试主导,这一步的收益被放大。
复现任何 SEED-VIG 结果之前,建议先用一个平凡基线(例如频带功率 + SVR)做校准:如果它在你的数据上只能拿到接近 0 的相关系数,说明问题出在数据对齐/预处理,而不是模型。
SEED-VIG 是上海交通大学 BCMI 实验室发布的、用于连续警觉度估计的多模态公开数据集,也是目前驾驶疲劳方向最常用的基准之一。
被试坐在真实汽车内,面对环形大屏运行虚拟驾驶任务,在接近真实的驾驶环境中持续驾驶约 2 小时(因此同时包含清醒段与疲劳段)。同步采集:
1_20151124_noon_2)本工作使用的 原始 SEED-VIG 数据集已随代码包一起提供,位于包根目录下的
data/SEED-VIG/ 文件夹中,解压后即可直接运行,无需另行申请或下载。代码中的数据路径默认值
已指向该目录,代码可以一键运行(见 第 8 节)。
<包根>/data/SEED-VIG/        # ← 数据集随包提供在这里
├── Raw_Data/               # 原始 EEG(本工作使用)
├── Raw_Data/               # 原始 EEG(本工作使用)
│   ├── 1_20151124_noon_2.mat      # 变量 EEG.data: (885*1600, 17) float64
│   ├── 2_20151106_noon.mat        # 变量 EEG.chn / sample_rate=200 / node_number=17
│   └── ... 共 23 个
├── perclos_labels/         # 标签,变量 perclos: (885, 1)
├── EEG_Feature_2Hz/        # 预提取特征: PSD/DE,17 × 885 × 25(2 Hz 分辨率,0–50 Hz)
├── EEG_Feature_5Bands/     # 预提取特征: PSD/DE,17 × 885 × 5(δ/θ/α/β/γ)
├── EOG_Feature/            # 前额 EOG 特征表 885 × 36(眨眼/扫视的率、幅值、时长及其方差等)
├── Forehead_EEG/           # 前额 4 通道的 EEG 特征,格式同上
├── Readme_English.txt
└── Readme_Chinese.txt
特征文件夹中每个 .mat 含四种变体:psd_movingAve、psd_LDS、de_movingAve、de_LDS(PSD / 微分熵,分别配滑动平均与线性动态系统平滑)。原始发布方给出的标准评测协议是:把每段记录平均切成 5 份做 5 折交叉验证,指标用相关系数 COR 与均方根误差 RMSE。
原始协议是被试内的(同一被试的数据既训练又测试),评估的是"个性化模型的拟合能力"。我们关注的是跨被试泛化——即新用户戴上设备后无需校准即可使用——因此采用 LOSO:
共训练 23 个模型,覆盖全部 20,355 条测试试次。指标为 Pearson 相关系数 CC 与 RMSE,既报告全部测试试次汇总的结果,也报告逐被试结果。
# 1) 读取连续信号并按试次切分
eeg = scipy.io.loadmat(f"Raw_Data/{name}.mat")["EEG"][0][0][0]    # (885*1600, 17)
eeg = filtfilt(b, a, eeg, axis=0)                                 # 1-50 Hz 零相位带通
X   = eeg.reshape(885, 8, 200, 17).transpose(0, 3, 1, 2)          # (885, 17, 8, 200)
X   = X.reshape(885, 17, 1600)                                    # (试次, 通道, 时间)
y   = scipy.io.loadmat(f"perclos_labels/{name}.mat")["perclos"][:, 0]   # (885,)

# 2) 欧氏对齐(Euclidean Alignment),逐被试白化
X = EA_offline(X, 1)      # 用该被试自身的平均协方差做 R^(-1/2) 变换

# 3) 送入模型前裁到前 7 秒(1400 点):为滑窗类变换预留 1 秒余量
X = X[:, :, :1400]
任务模型采用轻量级 EEGNet:时序卷积(核长 = 采样率/2 = 100)→ 逐深度空间卷积(核 = 17 通道)→ 可分离卷积,F1 = 8、D = 2、F2 = 16、dropout = 0.25,回归头为单个线性层。优化器 Adam,学习率 1×10⁻³,批大小 64,训练 100 个 epoch,损失为 MSE。源域被试先做逐被试欧氏对齐(EA)。
下表是 SEED-VIG 上跨被试回归(LOSO)的结果。最后一行为我们的复现结果。
| 类别 | 方法 | CC ↑ | RMSE ↓ |
|---|---|---|---|
| 无迁移学习 | PSD-MLP | 0.373 ± 0.007 | 0.331 ± 0.049 |
| EEGNet(无增强) | 0.618 ± 0.002 | 0.225 ± 0.004 | |
| 无监督域自适应 | EEGNet | 0.618 ± 0.006 | 0.223 ± 0.003 |
| DAN | 0.609 ± 0.011 | 0.216 ± 0.003 | |
| DANN | 0.612 ± 0.008 | 0.213 ± 0.003 | |
| CORAL | 0.611 ± 0.006 | 0.209 ± 0.003 | |
| DARE-GRAM | 0.609 ± 0.009 | 0.215 ± 0.003 | |
| 无反向传播的 测试时自适应 | BN-adapt | 0.618 ± 0.010 | 0.216 ± 0.004 |
| Aug-Scale | 0.619 ± 0.005 | 0.223 ± 0.003 | |
| Aug-Noise | 0.618 ± 0.006 | 0.222 ± 0.002 | |
| Aug-Freq | 0.617 ± 0.006 | 0.223 ± 0.002 | |
| Aug-Slide | 0.618 ± 0.004 | 0.223 ± 0.003 | |
| Mask-Mean(等权平均掩码分支) | 0.618 ± 0.006 | 0.218 ± 0.001 | |
| Aug-Mean(等权平均增强分支) | 0.625 ± 0.005 | 0.222 ± 0.003 | |
| BFT-D(我们的,确定性掩码 + 可靠性排序) | 0.623 ± 0.007 | 0.207 ± 0.002 | |
| BFT-A(我们的,知识驱动增强 + 可靠性排序) | 0.629 ± 0.005 | 0.208 ± 0.002 |
我们的方法用纯前向的方式取得了与需要反向传播的域自适应方法相当甚至更好的相关性,并且在 RMSE 上取得了全表最优(0.207 / 0.208)。更关键的是对比的结构性差异:
| 配置(EEGNet 骨干,LOSO 23 折,seed 42) | CC ↑ | RMSE ↓ |
|---|---|---|
| 原始数据(未带通滤波) | 0.4212 | 0.2793 |
| 1–50 Hz 带通滤波(本文标准流程) | 0.6307 | 0.2143 |
| 对照:上表中「EEGNet(无增强)」一行 | 0.618 | 0.225 |
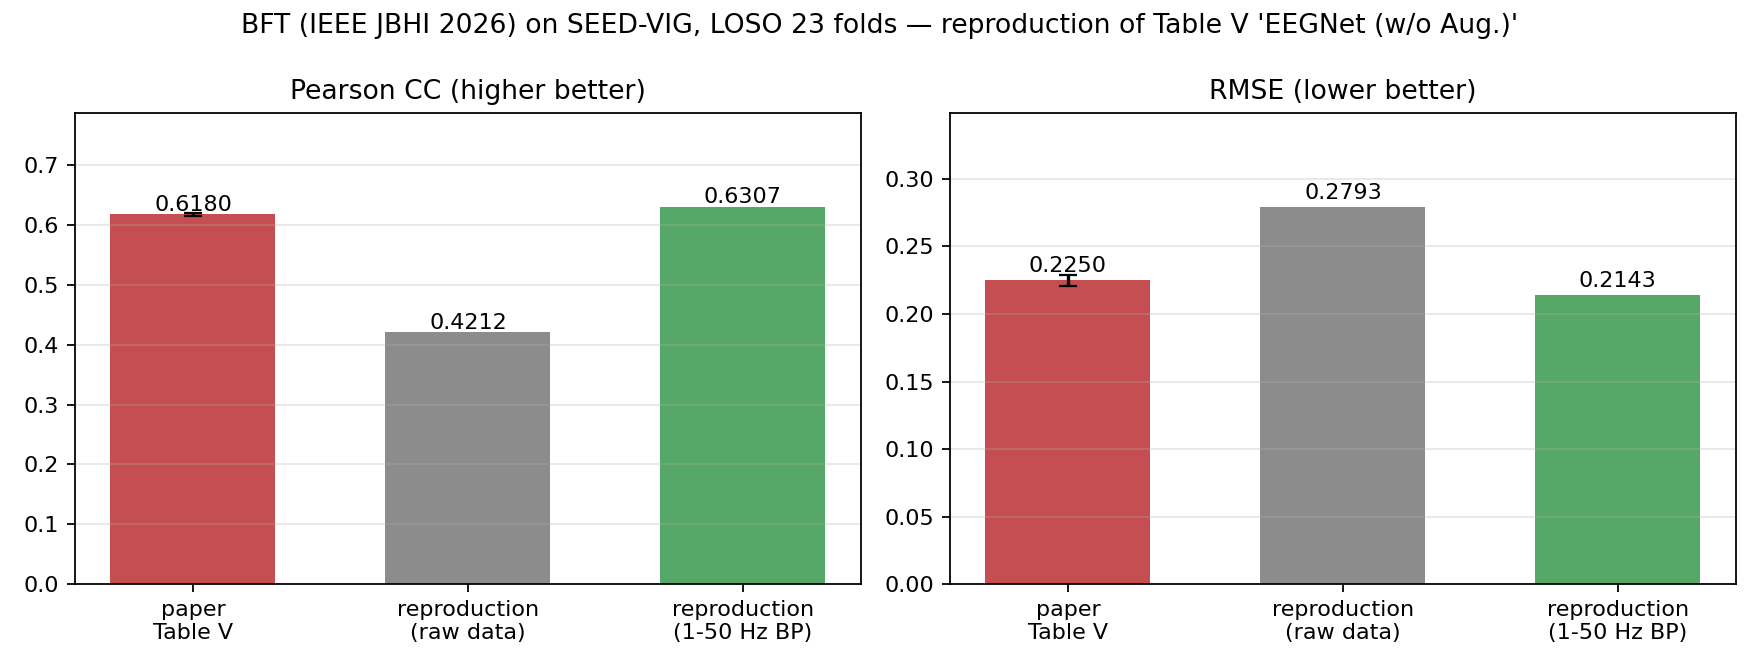
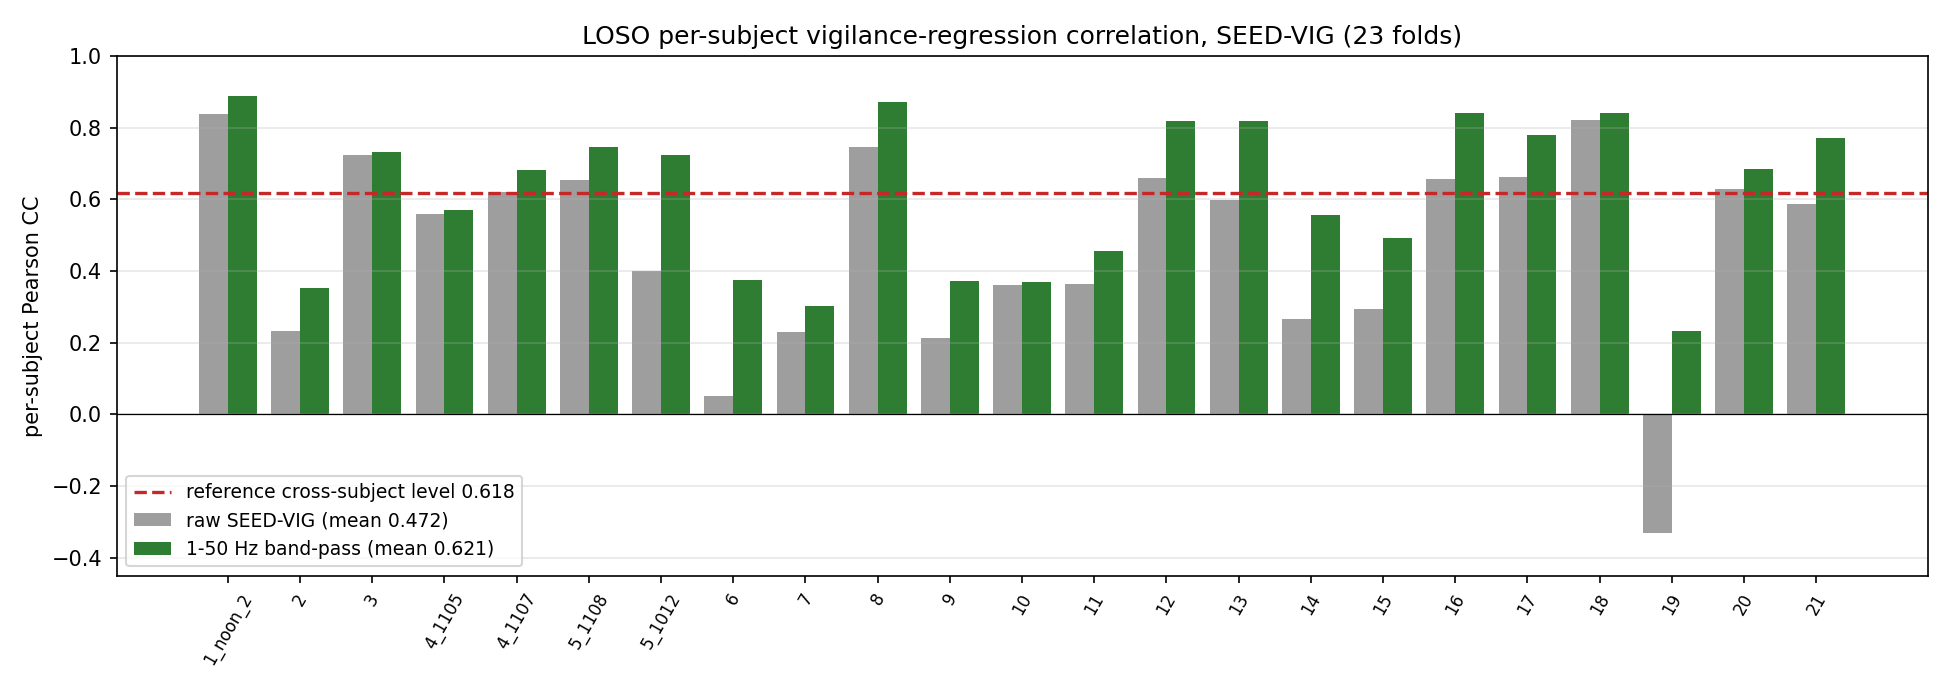
逐被试均值:未滤波 0.4715 ± 0.2740;滤波后 0.6208 ± 0.2047(均值 ± 标准差,n = 23)。滤波后逐被试 CC 全部为正,最小值 0.232,最大值 0.889。
max|EEG| > 500 µV 的大幅伪迹(被试 7 达 24%、被试 9 达 17%),这也是未滤波/未对齐流程脆弱的原因之一。EEG 在真实部署中不可避免地遇到体动、电极接触不良等污染。我们把七类测试时污染注入到测试试次上,观察相关性(CC)与 RMSE 的变化。下面给出两个驾驶疲劳回归数据集上的结果:
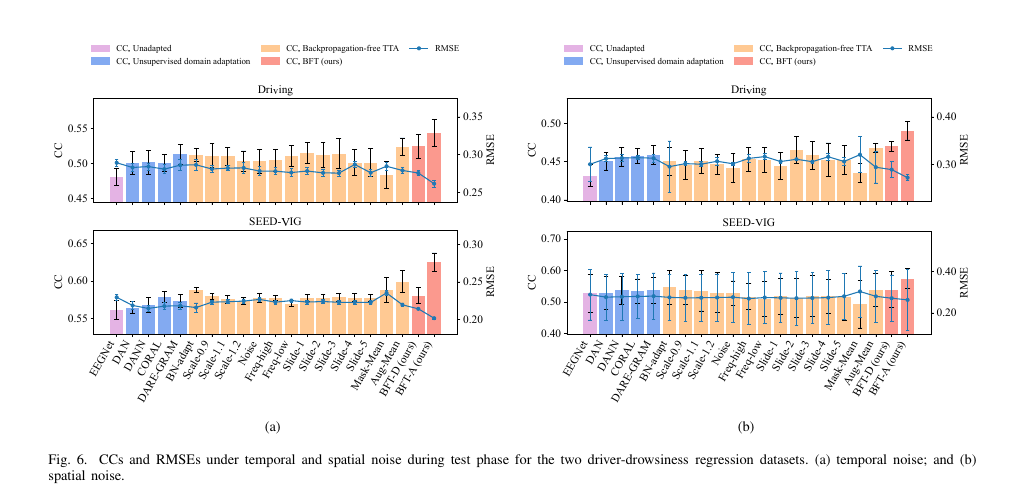
结论:由于变换库本身构成了对扰动的显式建模,我们的方法在污染条件下表现出更好的稳定性,而不是像基于熵最小化的方法那样容易被噪声样本带偏。
| 组件 | 版本 | 用途 |
|---|---|---|
| Python | 3.10 | 运行时 |
| PyTorch | 2.3.1 + CUDA 12.1 | 模型训练与推理 |
| NumPy | 1.26.4 | 数组运算 |
| SciPy | 1.10.1 | loadmat 读数据、butter/filtfilt/iirnotch 滤波 |
| scikit-learn | 1.7.2 | 标准化、SVR 基线、指标 |
| tqdm | 4.66 | 进度条 |
| Matplotlib | 3.10 | 结果绘图 |
| CUDA 驱动 | ≥ 12.1(实测 12.8 可用) | 单卡即可,本工作全部在 GPU 1 上完成 |
# 1) 创建独立环境
conda create -n bft python=3.10 -y
conda activate bft

# 2) 安装 PyTorch(按本机 CUDA 版本选择 wheel)
pip install torch==2.3.1 torchvision==0.18.1 --index-url https://download.pytorch.org/whl/cu121

# 3) 安装其余依赖
pip install "numpy==1.26.4" "scipy==1.10.1" "scikit-learn" "tqdm" "matplotlib"

# 4) 验证
python -c "import torch, scipy, sklearn; print(torch.__version__, torch.cuda.is_available())"
若机器上已有一个可用的 CUDA 版 PyTorch 环境,可用 venv --system-site-packages 继承它,只把缺的包装进隔离目录,既省磁盘又不动别人的环境:
# 假设已有 conda 环境 camera(python 3.10 + torch 2.3.1+cu121)
mkdir -p ~/work/bft && cd ~/work/bft
/home/ubuntu/miniconda3/envs/camera/bin/python -m venv --system-site-packages .venv
.venv/bin/pip install h5py lmdb einops scikit-learn       # 按需
.venv/bin/python -c "import torch; print(torch.cuda.is_available())"
若代码里出现
lmdb.Error: The environment ... is already open in this process
这是 lmdb ≥ 2.x 新增的同进程重复打开保护所致(原代码用 lock=False 打开同一路径三次)。解决办法是 pip install "lmdb==1.4.1",或改写数据加载器复用同一个 Environment。
所有实验只使用一张卡。通过环境变量指定,代码内部写死的设备号需要一并改掉:
export CUDA_VISIBLE_DEVICES=1        # 只暴露物理 GPU 1(进程内视为 cuda:0)
python run_loso.py --cuda 0 ...      # 脚本内的 --cuda 0 即指向物理 GPU 1
同时建议把源码里硬编码的 os.environ['CUDA_VISIBLE_DEVICES'] = '3,4,5,6,7' 一行删掉,否则会覆盖上面的设置,导致找不到设备。
# 包根目录
├── data/
│   ├── SEED-VIG/            # ★ 随包提供的原始数据集(3.0 GB,23 段记录)
│   │   ├── Raw_Data/        #   原始 EEG,23 个 .mat
│   │   ├── perclos_labels/  #   连续警觉度标签,23 个 .mat
│   │   ├── EEG_Feature_2Hz/ EEG_Feature_5Bands/ EOG_Feature/ Forehead_EEG/
│   │   └── Readme_English.txt  Readme_Chinese.txt
│   └── SEED_f1_50/          # 运行第 1 步后生成:1-50 Hz 滤波后的训练用 pkl
│
└── bft/
├── make_seed_pkl.py         # 官方 SEED-VIG → SEED_eeg_f.pkl / SEED_labels.pkl(含滤波、陷波、z-score 选项)
├── run_loso.py              # 23 折 LOSO 驱动脚本:训练 + 逐被试评估 + 汇总
├── summarize.py             # 合并并行结果,输出汇总 / 逐被试指标
    ├── DeepTransferEEG/     # 方法实现(models / utils / augment_utils / dropout_utils)
    └── results_*.json       # 逐折预测与标签(预置实验结果)
数据集已随包放在 <包根>/data/SEED-VIG/,所有数据路径都已预先配置好,
代码可以一键运行:把下面三段命令整体复制到终端依次执行,即可一次性完成
「数据构建 → 23 折 LOSO 训练与评估 → 结果汇总」全流程,无需修改任何代码,也无需指定任何路径。
# 进入方法目录
cd bft

# 第 1 步:构建训练数据(含 1-50 Hz 零相位带通)
#   默认读 <包根>/data/SEED-VIG,默认写到 <包根>/data/SEED_f1_50
python make_seed_pkl.py --bandpass 1,50 --order 4

# 第 2 步:LOSO 训练 + 评估(23 折,可切成多份并行)
CUDA_VISIBLE_DEVICES=1 python run_loso.py \
    --model-dir ./models/f1_50_seed42 \
    --folds 0,1,2,3,4,5 --seed 42 --max-epoch 100 --noaug \
    --out ./results_part0.json

# 第 3 步:汇总
python summarize.py "results_*.json"
三个脚本都保留了显式路径参数,指向别处即可:
make_seed_pkl.py --seedvig-root /your/path/SEED-VIG --out-dir /your/path/SEED_f1_50
run_loso.py --data-dir /your/path/SEED_f1_50