
商品详情
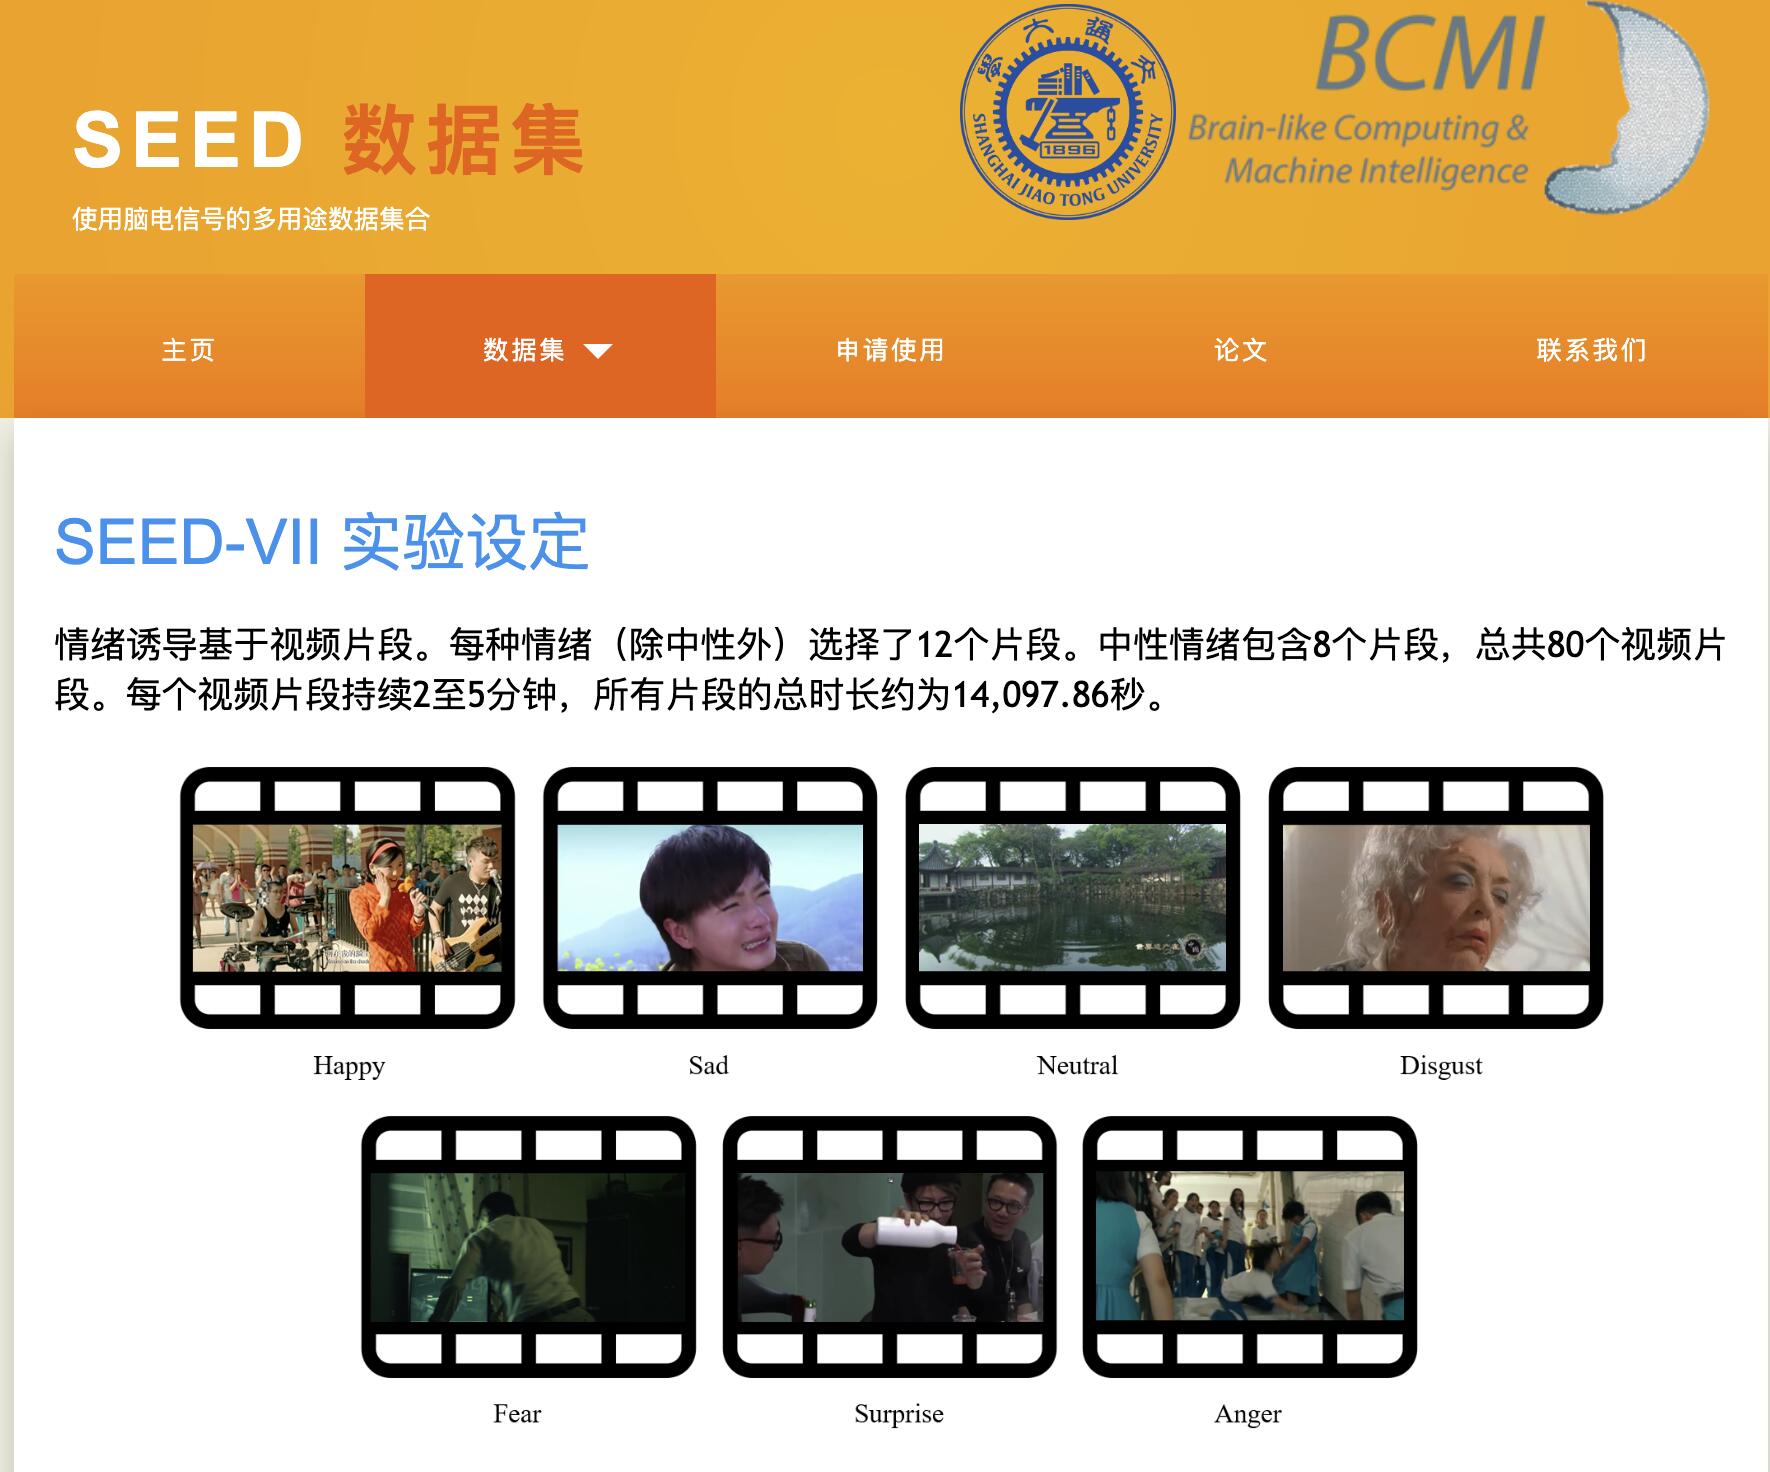
送SEED-VII数据集
多通道 EEG ・ 差分熵特征 ・ 傅里叶周期/非周期解耦 ・ 被试独立留一验证
脑电情绪识别要解决的核心矛盾是:EEG 既有明显的节律性(δ/θ/α/β/γ 频带上的准周期振荡), 又叠加了非周期的、与任务和个体相关的漂移成分。传统做法把两者混在一起送进网络, 让模型自己去隐式区分,结果往往是:
我们实现的方法针对上述三点,用一条主线串起来:
给定输入特征 x ∈ R^d_in,FAL 的输出由两部分拼接而成:
其中 ‖ 表示通道维拼接。两部分各自承担明确职责:
用无偏置线性变换先投影,再过余弦/正弦基函数。 这本质上是学习一组可训练的傅里叶基,使网络能直接表达任意相位的周期模式。 不使用偏置是关键——偏置会破坏基函数的相位结构。
保持纯线性(恒等激活)。这一点是相对前置工作 FAN 的关键改动:FAN 在非周期分支上仍加非线性激活,导致该分支不再是线性映射, 无法干净地替换 Transformer 中的线性投影层。改成恒等后,FAL 可以直接当作 Q/K/V 投影使用,同时保留周期建模能力。
设周期分支输出维度与总输出维度之比为 P-ratio。当 P-ratio = 0 时 FAL 退化为普通线性层, 因此这是一个可以平滑调节的开关(消融结果见第 5.4 节)。
用三个独立的 FAL 分别生成 Query / Key / Value,每个都被拆成周期与非周期两半:
两路各自独立计算缩放点积注意力,区别在于注意力分数上叠加了一项结构先验:
这里有两个要点:
最后按周期/非周期两路分别加权求和再拼接,得到 FAA 的输出:
保留多头设计(Multi-Head FAA)后,实现上把 8 个注意力头一分为二: 前 4 个头叠加周期邻接矩阵,后 4 个头叠加非周期邻接矩阵, 门控权重由对应 4 个头的 query 拼接后经 Linear(20→1) + Sigmoid 产生。
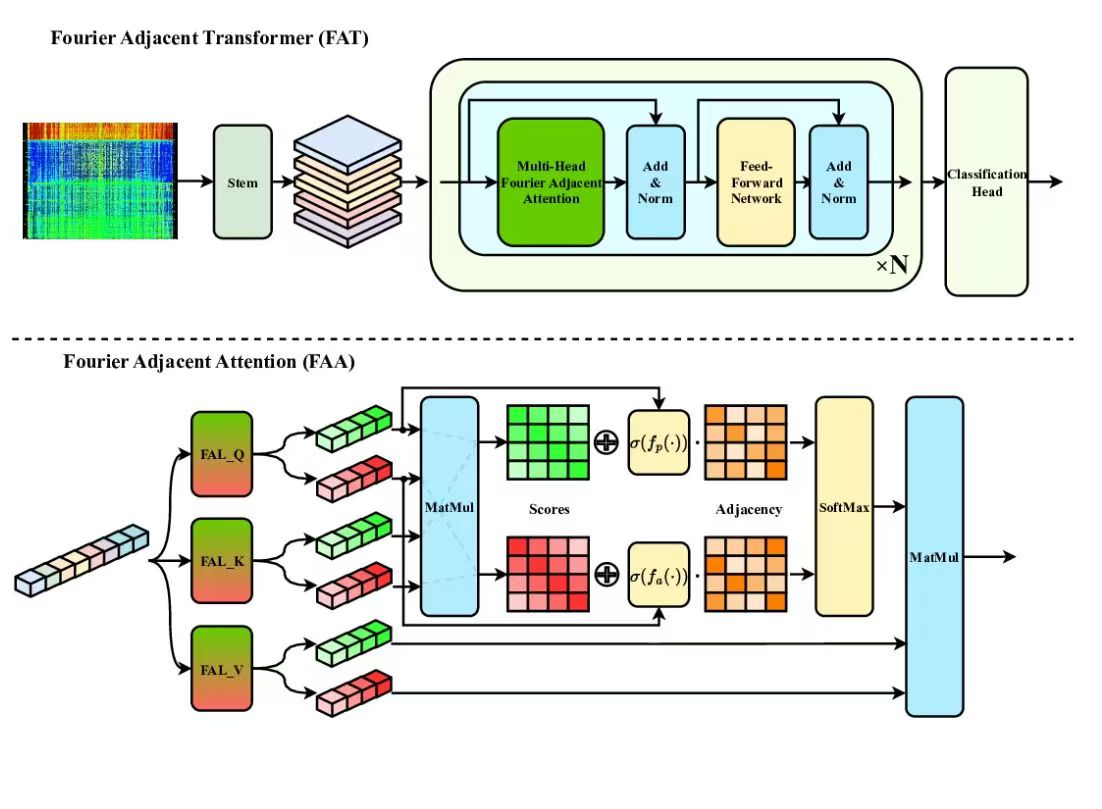
模型输入不是原始波形,而是每个时间窗的差分熵(DE)特征: 形状 B × C × F,其中 C = 62 个电极、F = 5 个频带。 DE 特征先经过一个两层 Stem 做通道维嵌入:
随后拼接一个可学习的 CLS token(序列长度 62 → 63),加上位置编码, 送入 N 个编码块。分类头只取 CLS token 位置的特征:
| 配置项 | 取值 | 说明 |
|---|---|---|
| 嵌入维度 E | 40 | Stem 输出通道数 |
| 编码块数 N (depth) | 6 | Transformer 层数 |
| 注意力头数 | 8 | 4 头接周期邻接、4 头接非周期邻接 |
| FFN 扩张比 | 4 | 40 → 160 → 40,GELU |
| Dropout | 0.2 / 0.5 | 注意力块 0.2,FFN 0.5 |
| 邻接矩阵尺寸 | 63 × 63 | 62 电极 + CLS token,跨深度共享 |
| 优化器 | Adam | lr = 1e-3,weight decay = 1e-4 |
| 批大小 / 轮数 | 32 / 50 | 每轮约 585 次迭代(session 1) |
| 可训练参数 | 168,555 | 非常轻量 |
0.05·sin(2t),强化周期性归纳偏置;SEED-VII 是上海交通大学 BCMI 实验室 SEED 系列的最新成员,把情绪类别扩展到 7 类,并且是 SEED 家族中首个同时提供离散标签与连续标签、 同时记录脑电与眼动的多模态数据集。
| 被试 | 20 人(10 男 / 10 女),年龄 19–26 岁,平均 22.5 岁;同时记录了 EPQ 人格量表得分(E/P/N/L) |
|---|---|
| 模态 | 62 通道 EEG + 同步眼动信号(本工作只使用 EEG 分支) |
| 采样率 | 原始 .cnt 为 1000 Hz;官方预处理后重采样至 200 Hz |
| 预处理 | 0.1–70 Hz 带通 + 50 Hz 陷波,剔除 M1 / M2 / ECG / HEO / VEO 等非脑电通道,重参考到 62 导联标准蒙太奇 |
| 实验结构 | 4 个 session × 20 个视频片段 = 每人 80 个片段,单个片段约 2 分钟 |
| 标签 | 离散标签(7 类)+ 逐秒连续标签(情绪强度轨迹) |
7 类情绪为 Happy / Neutral / Disgust / Sad / Anger / Fear / Surprise。 每个 session 只覆盖其中 5 类,每类 4 个片段(20 片段 / 5 类), 且顺序经过镜像平衡以抵消顺序效应:
| Session | 包含情绪 | 片段数 | 本 session 缺失 |
|---|---|---|---|
| Session 1 | Happy, Neutral, Disgust, Sad, Anger | 20 | Fear, Surprise |
| Session 2 | Anger, Sad, Fear, Neutral, Surprise | 20 | Happy, Disgust |
| Session 3 | Happy, Surprise, Disgust, Fear, Anger | 20 | Neutral, Sad |
| Session 4 | Disgust, Sad, Fear, Surprise, Happy | 20 | Neutral, Anger |
官方发布的 EEG 特征文件为每个片段提供三种逐秒特征,我们使用其中的 差分熵(DE, Differential Entropy)及其 LDS 平滑版本:
| 文件键 | 形状 | 含义 |
|---|---|---|
de_LDS_{i} |
(T, 5, 62) | 本工作使用。经线性动态系统平滑的 DE,逐秒一个时间窗 |
de_{i} |
(T, 5, 62) | 未平滑的原始 DE |
psd_{i} |
(T, 5, 62) | 功率谱密度 |
5 个频带为 δ(1–4 Hz) / θ(4–8 Hz) / α(8–14 Hz) / β(14–30 Hz) / γ(30–50 Hz)。 差分熵本质上是对数能量,在固定频带内与频带能量近似单调相关,是 SEED 系列上事实标准的特征。
| Session | 时间窗总数(20 人) | 人均窗口数 |
|---|---|---|
| Session 1 | 19,680 | 984 |
| Session 2 | 17,880 | 894 |
| Session 3 | 16,000 | 800 |
| Session 4 | 16,182 | 809 |
| 合计 | 69,742 | 3,487 |
每个被试 80 个片段;单个片段的窗口数在 13–87 之间(均值 43.6), 因为各视频时长不同。注意每个 session 的窗口总数不同—— 这意味着留一验证时每折的训练集大小都不一样,工程上需要留意(见第 5.7 节)。
SEED_VII/
├── EEG_raw/                 # 原始 .cnt(1000 Hz),每人 4 个 session
├── EEG_preprocessed/        # 预处理后原始波形(62ch, 200 Hz)
├── EEG_features/            # ★ 本工作使用:de_LDS_1..80 / de_1..80 / psd_1..80
├── continuous_labels/       # 逐秒连续情绪标签,键为片段编号
├── EYE_raw/  EYE_features/  # 眼动原始数据与特征
├── save_info/               # 触发器等采集元信息
├── src/                     # 官方预处理脚本 + 通道位置文件
├── emotion_label_and_stimuli_order.xlsx   # ★ 片段 → 情绪标签映射
├── subject info.xlsx        # 被试性别/年龄/人格量表
└── Channel Order.xlsx       # 62 电极顺序
pip install torch 会装到 cu130 的轮子, 而本机驱动是 570(CUDA 12.8),会报 CUDA initialization: The NVIDIA driver on your system is too old。 必须装 cu12x 系列,或使用下表已验证的组合。# 1) 基础环境(Python 3.9 / 3.10 均可) conda create -y -n seed7 python=3.10 conda activate seed7 # 2) PyTorch —— 必须匹配驱动的 CUDA 版本 pip install torch==2.4.0 torchvision==0.19.0 \ --index-url https://download.pytorch.org/whl/cu124 # 3) 其余依赖 pip install numpy==1.26.4 scipy scikit-learn pandas h5py openpyxl \ matplotlib einops tqdm # 4) 验证(应输出 True 和 2) python -c "import torch; print(torch.cuda.is_available(), torch.cuda.device_count())"
| 组件 | 本工作验证版本 | 备注 |
|---|---|---|
| OS | Ubuntu(内核 5.x) | — |
| GPU | NVIDIA RTX 3090 (24 GB) | 单卡即可,显存占用 < 2 GB |
| 驱动 | 570.195.03(CUDA 12.8) | 决定可用的 torch 轮子 |
| Python | 3.9.25 | 3.10 亦可 |
| PyTorch | 2.4.0+cu124 | 原仓库 requirements 写 2.2.2,本机驱动不支持更高版本 |
| NumPy / SciPy | 2.0.2 / 1.13.1 | 读 .mat 只需 scipy |
官方发布的 EEG_features 是每个被试一个文件、内含 80 个片段, 而留一验证需要按 session 切片。因此需要先做一次重排:
# 把官方 de_LDS 转成按 session 组织的、每被试一个文件的形式
python prepare_de.py
# 产出:DE/{1,2,3,4}/{1..20}.mat
#   DE       : (N, 62, 5)   float64   -- (时间窗, 电极, 频带)
#   labelAll : (N, 1)       float64   -- 0..6

# 脚本内含三重校验:
#   1) 形状断言
#   2) 标签分布对照 emotion_label_and_stimuli_order.xlsx
#   3) 与官方 de_LDS_1 的逐值 round-trip 比对
(通道数, 样本数, 频带数),但这是过时注释。 真实布局必须由下游脚本反推:np.concatenate(data_folds, axis=0) 之后 np.mean(all_data, axis=0) 要能得到 (62, 5) 的每通道归一化量, 只有 samples-first 的 (N, 62, 5) 才自洽。 按注释去做会得到静默错误的结果(不报错,但精度大跌)。# 单折调试(session 1,留出第 1 位被试) python run_loso.py --epochs 50 --no-compile \ --sessions 1 --folds-per-session 1 --out /tmp/one.json # 完整 80 折:每折一个独立进程,用并发填满 GPU 调度器 bash run_eager_parallel.sh # 汇总 python analyze_final.py
for session in {1,2,3,4}:            # 每个 session 20 个片段
    for held_out_subject in 1..20:    # 共 80 折
        test  = 该被试在该 session 的全部时间窗
        train = 其余 19 名被试在【同一 session】的时间窗
        逐文件做特征维 z-score
        Adam(1e-3, wd 1e-4) / batch 32 / 50 epochs
        指标 = 50 个 epoch 内在测试集上的最优准确率
| Session | 折数 | 均值 (%) | 标准差 | 最低 | 最高 |
|---|---|---|---|---|---|
| Session 1 | 20 | 54.64 | 9.26 | 38.8 | 73.6 |
| Session 2 | 20 | 54.12 | 9.44 | 34.9 | 76.7 |
| Session 3 | 20 | 54.91 | 8.10 | 42.1 | 73.5 |
| Session 4 | 20 | 49.47 | 8.60 | 34.1 | 62.2 |
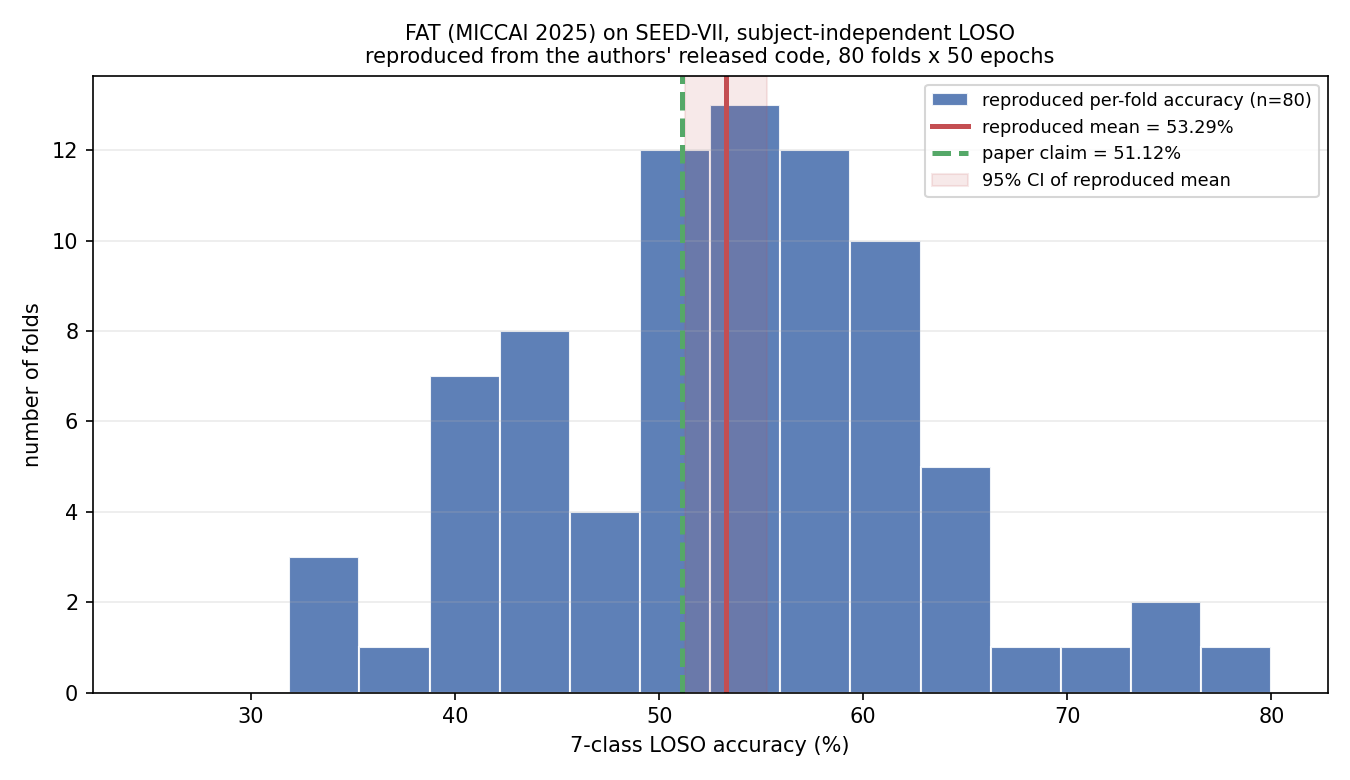
| 总体 | 80 | 53.29 | 9.14 | 34.1 | 76.7 |
Session 4 明显更难(49.47% vs Session 3 的 54.91%), 其情绪构成为 Disgust / Sad / Fear / Surprise / Happy —— 包含三个负性且相互易混的类别。
下表列出该方法论文中报告的 SEED-VII 被试独立结果,并附上我们的复现行。 所有方法的验证协议一致(同 session 内留一被试,7 分类)。
| 方法 | 准确率 / 标准差 (%) |
|---|---|
| KNN | 21.01 / 4.67 |
| SVM | 30.73 / 11.12 |
| DGCNN | 35.94 / 7.88 |
| BiHDM | 34.34 / 6.18 |
| RGNN | 37.49 / 5.44 |
| PGCN | 38.78 / 5.39 |
| Conformer | 45.60 / 9.74 |
| FAT (w/ FAN) | 49.00 / 10.32 |
| FAT(对照:原论文报告值) | 51.12 / 8.51 |
| FAT(本工作复现,80 折) | 53.29 / 9.14 |
相对表中最强基线 Conformer(45.60%),复现结果领先约 7.7 pp;相对最弱的 KNN(21.01%)领先约 32.3 pp。 这也说明被试独立场景下 SEED-VII 是相当困难的任务—— 7 类(单 session 内实际 5 类)的准确率普遍在 40–55% 区间, 远低于被试依赖(同一被试的数据同时出现在训练与测试中)的设定。
作为横向参照,下表列出该方法在被试依赖设定(训练集与测试集都包含全部被试的数据) 下报告的结果。本工作的实验全部在被试独立设定下完成,因此本节仅作参考,不含复现值。
| 方法 | 准确率 / 标准差 (%) |
|---|---|
| KNN | 36.87 / 4.41 |
| SVM | 40.07 / 8.61 |
| DGCNN | 46.36 / 7.33 |
| BiHDM | 45.57 / 8.75 |
| RGNN | 48.50 / 6.83 |
| PGCN | 49.94 / 7.48 |
| Conformer | 54.72 / 6.98 |
| FAT (w/ FAN) | 59.42 / 8.59 |
| 本方法(报告值) | 61.30 / 9.81 |
被试依赖设定下所有方法的数值都明显高于被试独立设定 (例如同一模型 61.30% vs 51.12%),因为训练集里已经见过测试被试的数据。 两种设定的数字不可直接比较。
| 输入频带 | 准确率 / 标准差 (%) |
|---|---|
| δ (1–4 Hz) | 40.97 / 7.77 |
| θ (4–8 Hz) | 41.34 / 5.45 |
| α (8–14 Hz) | 38.53 / 6.31 |
| β (14–30 Hz) | 42.31 / 5.77 |
| γ (30–50 Hz) | 41.03 / 8.65 |
| β + γ | 46.90 / 10.70 |
| β + γ + δ | 48.16 / 10.19 |
| 全频带 (5 band) | 51.12 / 8.51 |
| 评测预算 | 平均准确率 (%) |
|---|---|
| 前 5 个 epoch | 0.49 |
| 前 10 个 epoch | 0.51 |
| 前 20 个 epoch | 0.52 |
| 前 30 个 epoch | 0.53 |
| 前 40 个 epoch | 0.53 |
| 前 50 个 epoch | 0.53 |
到第 50 轮仍在缓慢上升(第 40→50 轮 +0.18 pp),说明开源实现中的 num_epochs = 50 是刚好够用的设置。
由于该指标是在测试集上取历史最优、且原论文未报告随机种子或重复次数, ±2 pp 的运行间抖动属于协议固有噪声。实测同一折换种子可以从 41% 波动到 56%(单折标准差远大于 80 折均值的标准误 1.03 pp), 因此这个量级的差异不构成"复现失败"的证据。
模型由大量微小算子拼成,每个训练步产生 1232 个 CUDA kernel。实测:
[0/63],每折 +1.2 s/epoch, 最终劣化到 150 s/epoch)。不要试图调大 cache_size_limit 来"解决"它。80 个进程同时运行会让部分进程在 cuBLAS 句柄创建处失败:
CUDA error: CUBLAS_STATUS_ALLOC_FAILED
when calling `cublasCreate(handle)`
第一轮 80 折中有 30 折因此丢失(无输出、无报错到主日志)。 降到并发 24 重跑后全部补齐。 建议并发不超过 ~32,并对每个 worker 加"检查产出文件、失败自动重试"的包装。